KI: Vom „Stochastischen Papagei“ zum Präzisionswerkzeug
ChatGPT allein reicht oft nicht aus, um komplexe journalistische Aufgaben zuverlässig zu bewältigen. Durch spezialisierte „Patterns“ und automatisierte Workflows lässt sich generative KI in ein erweitertes Gedächtnis verwandeln. So gelingt der Sprung von der vagen Anfrage zur belastbaren Faktenprüfung.
Von Klaus Kranewitter
Der Entwickler und Blogger Daniel Miessler veröffentlichte Anfang 2024 sein Open-Source-Projekt “Fabric” - ein Framework, das generative KI durch spezialisierte “Patterns” für wiederkehrende Aufgaben optimiert (Miessler 2024). Die Philosophie hinter dem Projekt: Statt ein Sprachmodell als Universallösung zu behandeln, lassen sich durch definierte Prompt-Vorlagen für spezifische Aufgaben - etwa das Zusammenfassen von Texten oder die Extraktion von Kernaussagen aus Transkripten - konsistentere Ergebnisse erzielen.
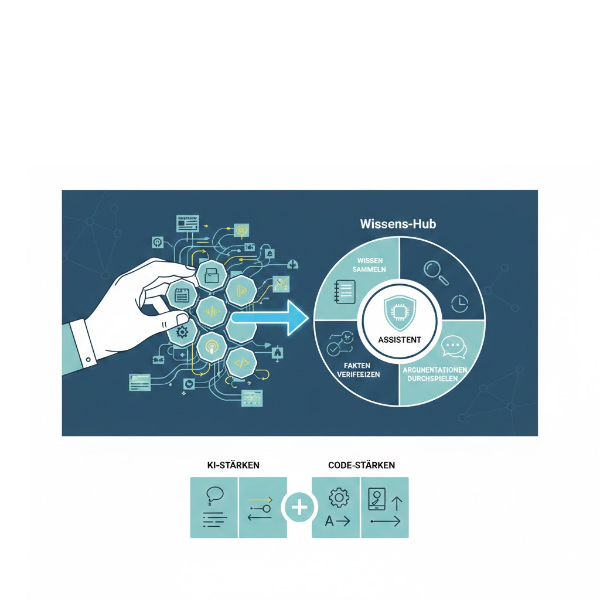
Diesen Ansatz habe ich für meine Arbeit adaptiert. Das Ergebnis ist ein persönliches Assistenten-System, das mich bei vier Kernaufgaben unterstützt: Wissen sammeln, Fakten prüfen, Kontext bewahren und Argumentationen durchspielen. Es handelt sich weniger um einen autonomen Agenten als vielmehr um ein erweitertes Gedächtnis mit eingebauter Recherche-Funktion.
Das Prinzip: Struktur reduziert Varianz
Eine zentrale Erfahrung nach Monaten der Nutzung: Ein gut strukturiertes System mit definierten Workflows liefert in meiner Praxis zuverlässigere Ergebnisse als unstrukturierte Eingaben an leistungsfähigere Modelle. Diese Beobachtung deckt sich mit Forschungsergebnissen zum Prompt Engineering, wonach die Formulierung der Eingabe einen erheblichen Einfluss auf die Ausgabequalität hat - in manchen Studien bis zu 50 Prozent der Leistungsunterschiede (MIT Sloan 2024).
Der Grund liegt in der Funktionsweise generativer KI: Large Language Models (LLMs) sind autoregressive, probabilistische Systeme - sie berechnen Wahrscheinlichkeitsverteilungen über mögliche nächste Tokens und wählen daraus mittels Sampling-Strategien (Vaswani et al. 2017). Klare Instruktionen können die Varianz dieser Vorhersagen reduzieren. Ein definierter Workflow für Faktenprüfung - erst Originalquelle identifizieren, dann Autorenschaft verifizieren, dann Kernaussage mit anderen Quellen abgleichen - führt zu nachvollziehbareren Ergebnissen als die vage Anweisung “prüf mal, ob das stimmt”.
Praktische Konsequenz: Ich investiere Zeit in die Struktur meiner Assistenten, nicht primär in die Auswahl des neuesten Modells. Wenn ein leistungsfähigeres Modell erscheint, kann das gesamte System davon profitieren - sofern die Workflows kompatibel bleiben. Allerdings erfordert ein Modellwechsel oft Anpassungen, da sich Tokenisierung, Faktenverhalten und Sicherheitsmechanismen zwischen Modellgenerationen unterscheiden können.
Vier Kernfunktionen für den Redaktionsalltag
Wissen sammeln und strukturieren: Medienschaffende stoßen täglich auf relevante Inhalte - ein YouTube-Interview mit einem Experten, ein Podcast mit einer interessanten These, ein Fachartikel zu einem Recherchethema. Das Problem: Diese Fundstücke verschwinden in Lesezeichen-Ordnern oder offenen Browser-Tabs und sind Wochen später nicht mehr auffindbar.
Mein System adressiert das durch einen Kuratierungs-Workflow: Ich übergebe einen Link, ein spezialisierter Assistent extrahiert die Kernaussagen aus dem Transkript oder Text, identifiziert erwähnten Personen und Institutionen, notiert Quellen und legt alles in einer durchsuchbaren Wissenssammlung ab. Der Mehrwert zeigt sich bei späteren Recherchen, wenn ich nach Themen oder Experten suchen kann statt mich durch unsortierte Lesezeichen zu klicken.
Fakten verifizieren
Vor der Weitergabe einer Information - ob in einem Artikel, einer Präsentation oder einem Social-Media-Post - kann ich sie systematisch prüfen lassen. Stimmt diese Statistik? Existiert die zitierte Studie? Hat die Person das tatsächlich gesagt?
Ein Recherche-Assistent durchsucht über angebundene Suchmaschinen und Datenbanken mehrere Quellen und gibt eine abgestufte Einschätzung: bestätigt, teilweise bestätigt, fragwürdig, widerlegt. Diese Abstufung ist wichtig - nicht jede Information lässt sich eindeutig verifizieren oder falsifizieren. Oft ist das Ergebnis “die Originalquelle sagt etwas Ähnliches, aber der Kontext fehlt”.
Kontext bewahren
Das System dokumentiert meine Arbeit. Ein Journal-Assistent protokolliert Arbeitsschritte und erstellt bei Bedarf Übergabe-Notizen. Wenn ich ein Rechercheprojekt nach Wochen wieder aufgreife, kann ich fragen “Was war der letzte Stand?” und bekomme den Kontext zurück - welche Quellen ich gesichtet hatte, welche Fragen offen waren, welche nächsten Schritte geplant waren.
Für Medienschaffende, die parallel an mehreren Projekten arbeiten, ist diese Kontinuität wertvoll. Das System vergisst nicht, auch wenn ich zwischendurch an anderen Themen gearbeitet habe.
Argumentationen durchspielen
Manchmal brauche ich einen Sparringspartner - nicht jemanden, der mir zustimmt, sondern jemanden, der systematisch Gegenargumente findet. Ein entsprechend konfigurierter Assistent ist darauf trainiert, Schwachstellen in Argumentationen aufzudecken: Welche Perspektive fehlt? Welche Annahmen sind fragwürdig? Welche Gegenbeispiele gibt es?
Das ersetzt nicht das Gespräch mit Kolleginnen und Kollegen, aber es ergänzt es - besonders bei Themen, bei denen ich Gefahr laufe, in einer Filterblase zu denken.
Code gegen bekannte KI-Limitationen
Sprachmodelle haben dokumentierte Limitationen: Sie halluzinieren gelegentlich Fakten - bei juristischen KI-Tools wurden Halluzinationsraten von 17 bis 69 Prozent gemessen (Stanford HAI 2024). Sie machen Fehler bei arithmetischen Operationen, wobei Tool-Integration (etwa Code-Interpreter) dieses Problem zunehmend adressiert. Sie verlieren bei langen Gesprächen Kontext, wobei insbesondere Informationen in der Mitte längerer Eingaben schlechter verarbeitet werden (“Lost in the Middle”-Effekt). Sie sind fehleranfällig bei exakter Textmanipulation (Bender et al. 2021).
Mein System adressiert diese Limitationen durch klassische Programmierung:
Dateiverwaltung erfolgt nicht durch das Sprachmodell, sondern durch definierte Tools. Wenn ich sage “speichere das ab”, führt Code die Operation aus - das Modell könnte den Dateipfad halluzinieren.
Textoperationen wie das Ersetzen von “ae” durch “ä” laufen über Skripte mit exakt definierten Ersetzungsregeln. Ein Sprachmodell würde dabei Fehler machen.
Aktuelle Informationen kommen nicht aus dem Modellwissen (das immer ein Stichtag-Datum hat), sondern durch Anbindung an echte Suchmaschinen und Datenbanken.
Dokumentenexport in Formate wie DOCX erfolgt über etablierte Werkzeuge wie Pandoc mit definierten Templates - deterministisch und reproduzierbar.
Das Prinzip: KI für das, was KI gut kann - verstehen, zusammenfassen, formulieren, Verbindungen herstellen. Code für das, was Code gut kann - exakt ausführen, zuverlässig speichern, deterministisch transformieren. Die Kombination ist robuster als reines Prompting.
Mehrere Modelle als Qualitätssicherung
Verschiedene Sprachmodelle haben verschiedene Stärken - und verschiedene blinde Flecken, die teilweise auf unterschiedliche Trainingsdaten und Architekturen zurückgehen. Forschung zu Ensemble-Methoden zeigt, dass die Aggregation mehrerer Modelle Fehlerraten senken kann (MIT 2024).
In meiner Praxis bedeutet das: Wenn ich eine wichtige Information verifizieren möchte, lasse ich sie von mehreren Modellen unabhängig prüfen. Die Ergebnisse unterscheiden sich oft in aufschlussreicher Weise - ein Modell könnte juristische Ungenauigkeiten identifizieren, ein anderes fehlende Gegenperspektiven, ein drittes bibliographische Unstimmigkeiten. Welche Modelle welche Fehlertypen zuverlässiger finden, ist dabei nicht systematisch vorhersagbar; die Komplementarität ergibt sich empirisch.
Das ist aufwändiger als eine einzelne Anfrage, aber für Texte, die veröffentlicht werden sollen, kann sich dieser Multi-Model-Ansatz lohnen. Allerdings ist zu beachten, dass Modelle häufig ähnliche Trainingsdaten teilen und daher auch ähnliche Fehler machen können - Übereinstimmung zwischen Modellen ist kein Wahrheitsbeweis.
Grenzen und Verantwortung
Das System ist ein Werkzeug zur Erweiterung meiner Fähigkeiten, kein Ersatz für journalistisches Handwerk.
Ich kann schneller recherchieren als früher. Ich kann mehr Quellen prüfen als früher. Ich kann Argumentationen systematischer durchspielen als früher. Aber die Entscheidungen treffe ich. Die Schlüsse ziehe ich. Die Verantwortung für das, was ich publiziere, liegt bei mir.
Ein Faktencheck-Assistent kann mir sagen, ob eine Quelle existiert und was sie enthält. Ob die Schlussfolgerung daraus richtig ist, muss ich selbst beurteilen. Ein Recherche-Assistent liefert mir Informationen. Welche davon relevant sind und wie ich sie gewichte, entscheide ich.
Das ist kein Defizit des Systems. Das ist der Punkt. KI soll dem Menschen dienen - seine Fähigkeiten erweitern, nicht ersetzen. Ein Werkzeug, das mir das Denken abnimmt, wäre keine Hilfe, sondern eine Entmündigung.
Warum der Aufwand?
Natürlich könnte ich auch einfach ChatGPT oder Claude direkt nutzen - ohne spezielle Konfiguration, ohne Struktur, ohne Workflows. Für schnelle Fragen mache ich das auch. Aber für wiederkehrende Aufgaben im Redaktionsalltag bietet das strukturierte System Vorteile:
Spezialisierung: Ein Assistent, der ausschließlich kuratiert, kann gründlicher arbeiten als ein Generalmodell, das nicht weiß, was ich eigentlich will.
Persistenz: Das System bewahrt Kontext. Meine Wissenssammlung wächst über die Zeit. Ein Chat-Interface vergisst nach jeder Session.
Robustheit: Durch die Integration von Code fallen typische KI-Fehler weg - keine halluzinierten Dateipfade, reduzierte Rechenfehler, keine vergessenen Kontexte.
Reproduzierbarkeit: Die Assistenten arbeiten nach definierten Workflows. Ich muss nicht jedes Mal neu erklären, was ich brauche - wobei vollständige Reproduzierbarkeit bei probabilistischen Systemen ohne strikte Parameterfixierung nicht garantiert ist.
Im Kern zeigt sich: Generative KI wird nützlicher, wenn man sie für spezifische Aufgaben konfiguriert und ihre Limitationen durch Struktur und Automation kompensiert. Das Ergebnis ist kein autonomes System, das eigenständig arbeitet, sondern ein Werkzeug, das mich besser macht in dem, was ich ohnehin tue - sammeln, kuratieren, prüfen, erinnern, bewerten.
Hinweis: Bei der Verarbeitung urheberrechtlich geschützter Inhalte sind die Regelungen zum Text und Data Mining (§ 44b UrhG) sowie etwaige Opt-out-Erklärungen der Rechteinhaber zu beachten. Bei der Nutzung von KI-Systemen in der journalistischen Praxis sind neben urheberrechtlichen Fragen auch datenschutzrechtliche Aspekte (DSGVO) sowie redaktionelle Transparenzpflichten zu berücksichtigen.